Cerebras mengumumkan pengerahan model kecerdasan buatan berkapasitas triliunan parameter yang memanfaatkan aliran permintaan secara serentak. Jumlah total permintaan bersamaan ini menggambarkan banyaknya permintaan simultan yang bergerak melalui pipa pemrosesan pada satu waktu.
Kinerja Sistem Inferensi
Tidak seperti kelompok unit pemrosesan grafis konvensional, permintaan-permintaan tersebut tidak saling menunggu hingga selesai, melainkan mengalir secara berkelanjutan melalui pipa. Meskipun demikian, faktor konkurensi maupun ukuran kelompok tidak secara otomatis menunjukkan tingkat efisiensi kinerja sebuah sistem inferensi secara presisi.
Saat mengukur keluaran dari sebuah sistem inferensi, metrik yang dinilai lebih bermakna adalah total keluaran token per satuan daya, seperti token per detik per megawatt, tatkala diukur pada kecepatan pembuatan keluaran yang setara.
Skala Melebihi Tiga Triliun Parameter
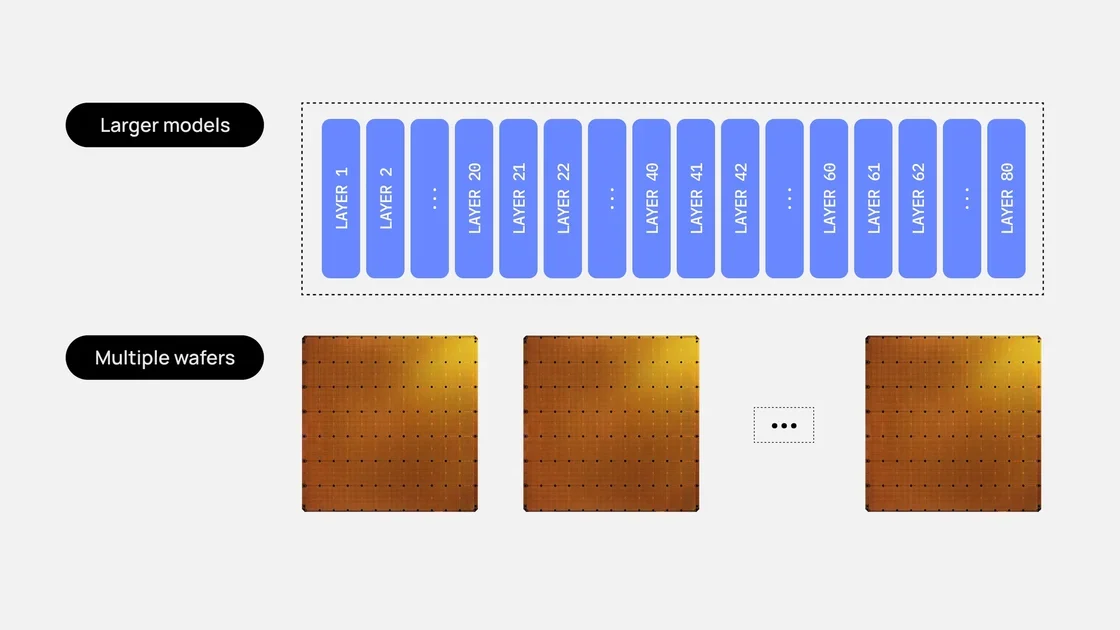
Pendekatan serupa dapat diperluas untuk menangani model yang jauh lebih besar. Langkah yang ditempuh meliputi penghitungan memori yang diperlukan untuk bobot serta status permintaan, mendistribusikan model ke berbagai wafer, dan menghubungkannya ke dalam satu jalur pipa.
Setiap tambahan wafer menyumbang kapasitas komputasi serta memori di atas cip, yang memungkinkan sistem untuk menampung model-model yang melampaui kapasitas satu cip tunggal.
Pihak pengembang menyediakan akses bagi pihak yang berminat menggunakan model pada platform Cerebras atau membangun sistem melalui komputasi awan inferensi mereka. Pengguna dapat mulai memanfaatkan antarmuka pemrograman aplikasi gratis melalui situs cloud.cerebras.ai atau menghubungi tim penjualan melalui alamat [email protected].
Sumber: Hacker News: Front Page