Daftar Isi
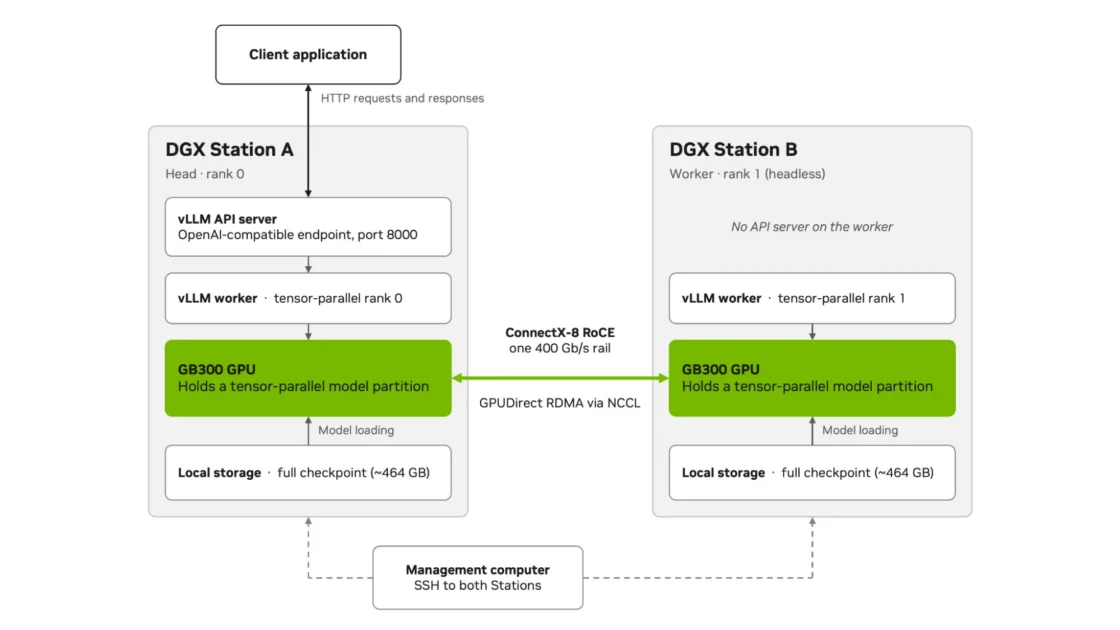
Menjalankan model berskala perbatasan secara lokal mengharuskan penyimpanan seluruh bobotnya di dalam memori GPU karena model terbesar sudah tidak lagi muat pada satu mesin saja. Dua NVIDIA DGX Station yang terhubung melalui ConnectX-8 RDMA menyajikan satu model lewat satu titik akhir tunggal dengan paralelisme tensor yang membagi bobot serta komputasi model ke kedua GPU.
Persiapan Perangkat dan Pengunduhan Model
Model NVIDIA GLM-5.3 NVFP4 merupakan versi terkuantisasi dari model Mixture-of-Experts milik Z.ai yang memiliki 753 miliar parameter dengan 40 miliar parameter diaktifkan per token. Pengaktifan jarang mengurangi komputasi, tetapi seluruh bobot model tetap harus tersedia karena setiap token dapat diarahkan ke pakar yang berbeda. Titik pemeriksaan atau checkpoint yang berukuran sekitar 464 gigabita melampaui kapasitas 252 gigabita HBM3e pada satu GPU GB300, sehingga tutorial ini menggunakan dua DGX Station agar bobot tetap berada di dalam memori GPU tanpa pengalihan bobot CPU.
Sebelum memulai, sambungkan kedua Station dengan panduan Connect Two DGX Stations, serta pastikan Anda memiliki akses SSH dan sudo di kedua Station dengan nama pengguna Linux yang sama. Docker dan NVIDIA Container Toolkit sudah terpasang sebelumnya dengan perangkat lunak DGX Station, sementara ruang kosong pada diska minimal 464 gigabita dibutuhkan di setiap Station untuk salinan checkpoint beserta ruang bagi citra kontainer vLLM dan berkas sementara. Pengguna juga wajib menyetujui Perjanjian Model Terbuka NVIDIA dan ketentuan lisensi asli GLM-5.3 pada kartu model, serta memiliki akun Hugging Face beserta token akses baca untuk dataset cais/hle.
Menjalankan Layanan Terdistribusi dan Verifikasi
Prosedur ini mengubah dua mesin menjadi satu layanan di mana skrip peluncuran yang sama berjalan pada kedua Station, membaca berkas lingkungan masing-masing, dan memulai satu peringkat vLLM pada setiap mesin. Dua pengaturan utama yang berpengaruh adalah batasan konteks sebesar 98.304 token dan pemanfaatan memori GPU sebesar 93 persen. Skrip tersebut mengaktifkan prediksi multi-token sebagai bentuk dekoding spekulatif, penyimpanan tembolok KV FP8 yang memangkas memori tembolok setengah dari penyimpanan 16-bit, serta tembolok prefiks untuk menghindari pemrosesan ulang prefiks prompt yang sudah dilihat peladen.
Setelah kontainer berjalan di Station B lalu Station A, setiap Station memuat bagian bobotnya dari penyimpanan lokal, menyiapkan kernel, dan menangkap grafik CUDA yang memerlukan waktu beberapa menit. Pemeriksaan kesehatan membuktikan bahwa Station A merespons permintaan dengan baik, sementara log NCCL memastikan peringkat berkomunikasi melalui RDMA GPU alih-alih soket TCP. Pada nvidia-smi, Station A menampilkan proses pekerja VLLM untuk peringkat nol dan Station B menampilkan peringkat satu, yang mengonfirmasi bahwa model terbagi di antara kedua GPU.
Pengukuran Kinerja Konkurensi
Alat benchmarking AIPerf dari NVIDIA mengukur throughput dan latensi pada titik akhir inferensi dengan menggunakan 80 percakapan pengkodean dari SPEED-Bench untuk mengukur dekoding spekulatif pada teks realistis. Pengujian penuh mencakup tingkat konkurensi 1, 8, 16, dan 32, di mana AIPerf mengirimkan sejumlah permintaan pemanasan diikuti oleh pengukuran permintaan berdasarkan tingkat konkurensi tersebut. Seluruh permintaan penanda tolok ukur menggunakan upaya penalaran bawaan model serta batas keluaran 8.192 token.
Throughput keseluruhan mencapai puncaknya pada 607,8 token per detik pada konkurensi 16, lalu turun menjadi 385,0 token per detik pada konkurensi 32 dengan latensi rata-rata permintaan mencapai 453,5 detik. Konkurensi yang lebih tinggi juga menurunkan throughput rata-rata per pengguna dari 115,3 token per detik pada konkurensi 1 membuka hingga 13,0 token per detik pada konkurensi 32.
Setelah penghentian kontainer vLLM pada Station A kemudian Station B, status proses akan berubah menjadi keluar tanpa menyisakan proses vLLM apa pun di dalam pemantauan GPU, sementara checkpoint, kontainer, dan hasil pengujian tetap tersimpan di dalam diska untuk digunakan kembali sewaktu-waktu.
Sumber: Hacker News: Front Page