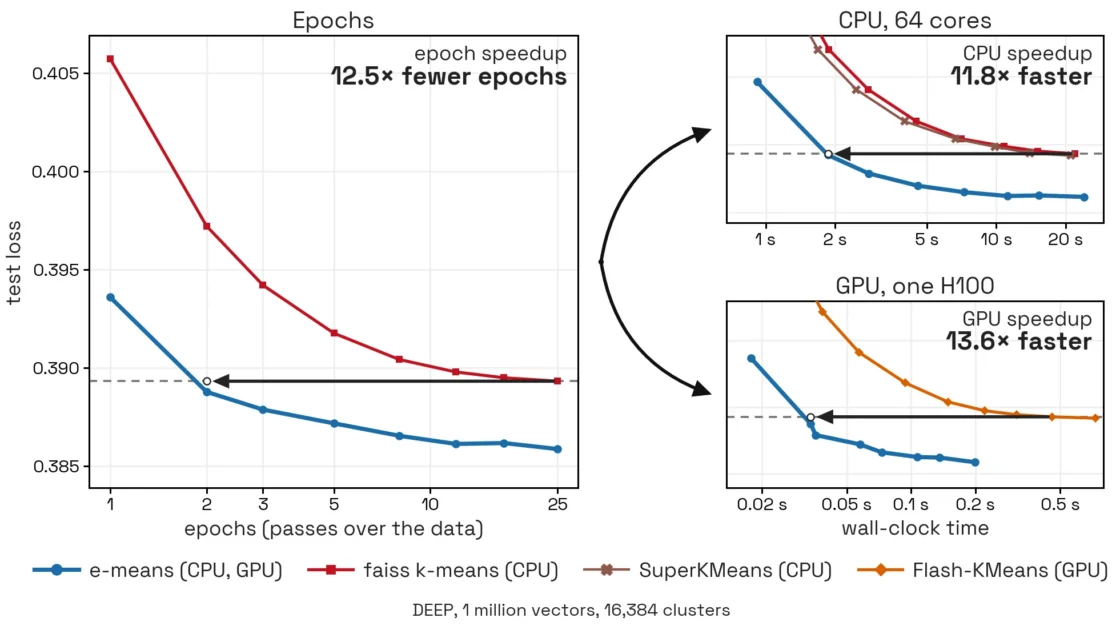
Metode klasterisasi e-means berhasil mencapai kerugian uji di bawah algoritma Lloyd hanya dalam 1,2 hingga 3 epok. Berdasarkan pengukuran menyeluruh dari Hacker News, pendekatan ini memberikan pengurangan waktu pada GPU sebesar 10 hingga 45 kali lipat dibandingkan implementasi Flash-KMeans, serta 8 hingga 15 kali lipat pada CPU terhadap Faiss.
Aturan Pembaruan Centroid dan Perbandingan
Masalah k-means bertujuan menemukan k centroid untuk meminimalkan jarak kuadrat rata-rata antara titik data dan centroid terdekatnya. E-means dikembangkan sebagai aturan optimasi modern untuk mengatasi masalah ini melalui pembaruan mini-batch menggunakan rata-rata bergerak eksponensial (EMA). Berbeda dari metode mini-batch konvensional berbasis aturan MacQueen dari tahun 1967, e-means menetapkan ukuran batch dan langkah secara otomatis menggunakan hukum penskalaan tanpa memerlukan penyetelan hiperparameter tambahan.
Algoritme Lloyd tradisional melakukan penetapan titik ke centroid terdekat dan menghitung ulang statistik dari awal dengan biaya satu kali penuh melewati data per pembaruan. Sementara itu, e-means menggunakan EMA sehingga penugasan yang lebih lama dilupakan pada tingkat alpha tertentu, yang membuat centroid melacak penugasan baru. Proyek e-means sendiri berakar dari penelitian sebelumnya di Meta FAIR oleh Hugo Touvron dan Hervé Jégou yang menunjukkan bahwa mini-batch k-means melalui penurunan gradien dapat mengungguli algoritme Lloyd.
Peningkatan Keluar dari Minimum Lokal dan Revitalisasi Klaster
Evaluasi pada kumpulan data mainan menunjukkan bahwa e-means jauh lebih kecil kemungkinannya terjebak dalam konfigurasi patologis dibandingkan Lloyd. Pembaruan mini-batch yang bising membantu mengeksplorasi lanskap optimasi dengan lebih baik untuk keluar dari minimum lokal, sedangkan Lloyd cenderung mengeksploitasi minimum lokal yang ditemukan tanpa jalan keluar.
Selain itu, e-means mengatasi masalah klaster mati dengan memecah klaster aktif yang besar secara proporsional dengan ukurannya, mengadaptasi pendekatan dari Faiss k-means. Pendekatan revitalisasi ini dinilai jauh lebih efektif dalam menghilangkan klaster mati dan menjaga kapasitas buku kode dibandingkan metode penggantian sampel acak sederhana.
Validasi ekstensif telah dilakukan pada 24 konfigurasi dan kumpulan data penyematan yang berbeda, serta diuji dalam 234 konfigurasi terhadap k-means standar pada rentang 100 ribu hingga 100 juta poin data. Kode dan perangkat lunak untuk metode ini tersedia melalui repositori faiss/contrib/e_means, dan rincian lengkapnya dapat merujuk pada makalah arXiv:2611.09501.
Sumber: Hacker News: Front Page