Daftar Isi
PENGGUNA Platypush membagikan pembaruan terkait perombakan pipa asisten suara lokal untuk mengatasi masalah positif palsu dan meningkatkan keandalan deteksi suara. Setelah melakukan beberapa uji coba, sistem yang diperbarui ini menggunakan plugin baru dan peningkatan pemrosesan audio untuk hasil yang lebih memuaskan.
Deteksi Wake Word dengan Microwakeword
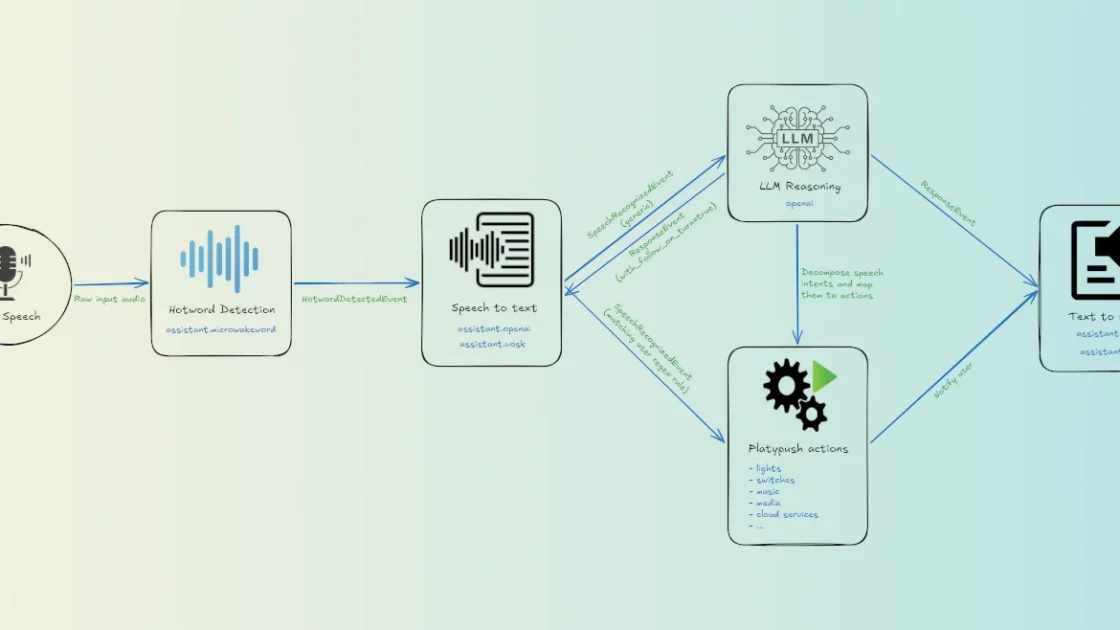
Sebelumnya, sistem ini mengandalkan assistant.openwakeword yang membungkus openWakeWord. Kendati berfungsi, proyek tersebut dinilai kurang aktif dan model pra-latihannya masih menggunakan versi lama dari tahun 2023 yang sebagian besar dilatih menggunakan data sintetis. Kondisi ini kerap memicu positif palsu akibat derau latar belakang serta negatif palsu saat pengguna berada agak jauh dari mikrofon.
Sebagai solusi, ditambahkan plugin baru bernama assistant.microwakeword yang memanfaatkan mesin microWakeWord melalui pustaka Python pymicro-wakeword. Mesin ini aktif digunakan oleh ESPHome dan Home Assistant Voice dengan model bawaan seperti okay_nabu, hey_jarvis, hey_mycroft, dan alexa yang sudah tersedia di dalam paket tanpa perlu diunduh terpisah. Pengguna juga dapat memasukkan model kustom dengan menempatkan manifes JSON dan model .tflite ke dalam direktori plugin.
Peningkatan Deteksi Suara dan Transkripsi
Bagian transkripsi ucapan menggunakan assistant.openai bersama Whisper untuk merekam dan mengubah audio saat percakapan dimulai. Tantangan terbesar sebelumnya adalah mendeteksi akhir percakapan secara akurat karena detektor WebRTC VAD sebelumnya menganggap derau sesaat sebagai ucapan, sehingga membuat durasi percakapan terus memanjang hingga batas maksimal.
Lapisan prapemrosesan audio kini telah dirombak total dengan menggunakan Silero VAD sebagai backend utama melalui onnxruntime tanpa memerlukan PyTorch. Sistem ini dipadukan dengan WebRTC VAD serta detektor berbasis RMS sebagai cadangan. Model Silero diunduh otomatis pada penggunaan pertama dan diverifikasi checksum-nya untuk memastikan keamanannya.
Selain itu, sistem kini menerapkan histeresis dan jendela geser dengan pemungutan suara mayoritas, serta lantai derau adaptif untuk melacak tingkat kebisingan latar belakang. Berdasarkan pengujian sintetis, pipa baru ini mampu menutup percakapan dalam waktu satu hingga 1,6 detik setelah kata terakhir diucapkan, jauh lebih cepat dibanding pengaturan lama yang memakan waktu enam hingga sepuluh detik.
Respons dan Kendala Teknis
Frasa yang telah ditranskripsi kemudian diproses melalui plugin openai untuk mengelola kunci API dan konteks percakapan. Respons ucapan dirender menggunakan tts.openai dengan pengaturan volume dan suara yang dapat disesuaikan, sementara tts.piper menjadi alternatif lokal meski menambahkan latensi sekitar tiga hingga empat detik pada perangkat Raspberry Pi 5.
Sejumlah catatan penting disampaikan terkait pengoperasian sistem ini. Mikrofon pada perangkat Raspberry Pi penulis tidak mendukung frekuensi 16 kHz secara native, sehingga audio ditangkap pada 44,1 kHz dan diproses ulang secara software yang berpotensi memengaruhi kelambatan deteksi. Pengaturan bawaan VAD dan ambang batas juga disesuaikan dengan kondisi akustik tertentu, sehingga pengguna mungkin perlu menyetel ulang parameter detection_threshold dan noise_floor_factor sesuai lingkungan masing-masing.
Sumber: Hacker News: Front Page