Daftar Isi
Large Language Model (LLM) terus berkembang pesat, dan salah satu komponen penting yang mendasarinya adalah cara model merepresentasikan posisi token dalam teks. Artikel ini mengupas berbagai metode penyematan posisi (positional embeddings), mulai dari pendekatan absolut klasik hingga metode relatif kontemporer seperti Rotary Position Embedding (RoPE).
Di Mana Informasi Posisi Masuk ke dalam LLM
Sebuah tokenizer mengubah teks masukan menjadi ID token, yang kemudian dipetakan oleh lapisan embedding token ke dalam vektor angka atau fitur. Blok transformer di dalam LLM memodifikasi vektor-vektor ini menggunakan lapisan perhatian (attention) dan *feedforward*. Pada akhirnya, lapisan keluaran model menghasilkan skor logit untuk token berikutnya.
Dalam model klasik seperti GPT-2, vektor posisi ditambahkan ke setiap embedding token sebelum masuk ke blok transformer pertama. Sebaliknya, model yang lebih baru seperti MiniMax-M3 menambahkan informasi posisional di dalam setiap blok transformer menggunakan metode RoPE di dalam mekanisme atensi. Informasi posisi eksplisit ini sangat berguna karena memberikan sinyal langsung mengenai jarak dan urutan token, melengkapi informasi urutan implisit yang sudah ada dari penutup kausal (*causal mask*).
Menambahkan Vektor Posisi dan Penggunaan RoPE
Pendekatan paling langsung adalah memberikan vektor tersendiri untuk setiap posisi urutan dan menambahkannya ke embedding token. GPT-2 menggunakan tabel vektor posisi yang dipelajari selama pelatihan, sementara transformer asli dari tahun 2017 menggunakan fungsi sinus dan kosinus tetap. Namun, metode absolut ini memiliki batasan dalam hal penambahan panjang konteks karena ukuran tabel yang semakin besar.
Untuk mengatasi keterbatasan tersebut, RoPE diperkenalkan dalam makalah RoFormer tahun 2021 sebagai metode posisi relatif. RoPE menggunakan posisi token untuk memutar vektor *query* dan *key* sebelum menghitung perkalian titik (*dot product*), sementara vektor *value* dibiarkan tanpa rotasi. Menurut penjelasan dalam Hacker News: Front Page (magazine.sebastianraschka.com), keunggulan utama RoPE adalah ketika kedua posisi digeser sejauh jumlah yang sama, perbedaan sudut rotasi tetap terjaga sehingga mempertahankan skor atensi yang konsisten.
Pilihan Posisional dalam Arsitektur Modern
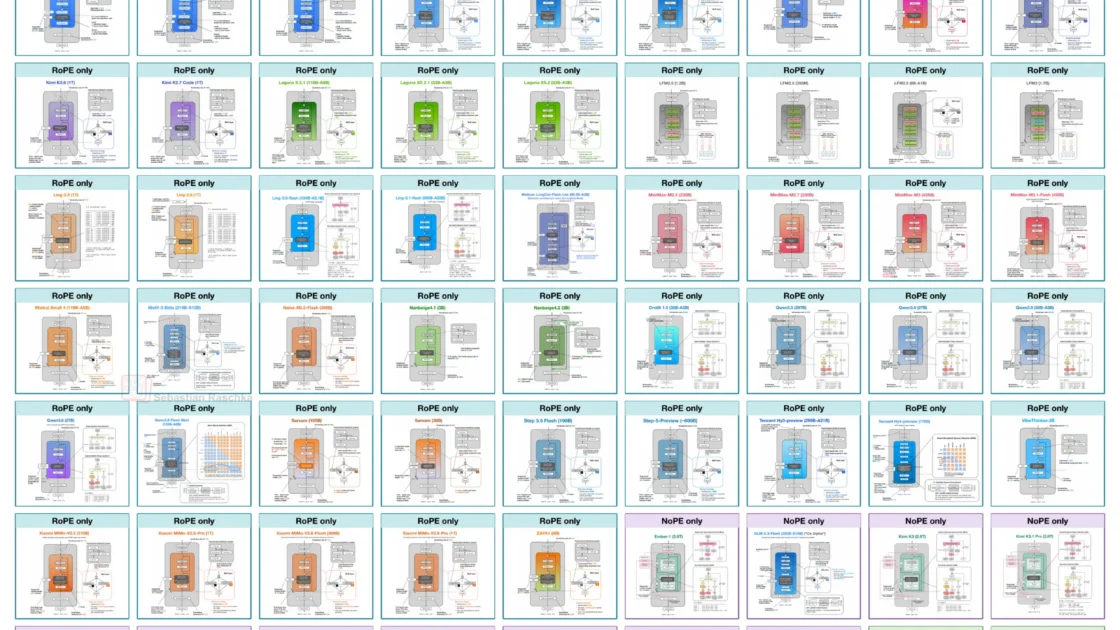
Meskipun RoPE telah menjadi standar dalam sebagian besar model sumber terbuka sejak kemunculan LLaMA, arsitektur modern kini mulai mengadopsi variasi lain. Sebagian model menggunakan *Partial RoPE* yang hanya merotasi sebagian dimensi di dalam setiap kepala atensi guna menghemat memori, sementara model lainnya menerapkan pendekatan NoPE (*No Positional Encoding*) yang sepenuhnya mengandalkan penutup kausal untuk menangkap informasi posisi secara implisit.
Eksperimen menunjukkan bahwa metode NoPE mampu menangani konteks yang melampaui panjang data pelatihan pada tugas-tugas tertentu, meskipun beberapa model modern kini memilih untuk menghilangkan RoPE pada sebagian lapisan transformer saja.
Sumber: Hacker News: Front Page